May 5, 2026 | 8 minutes
Artículo histórico de Make (la fuente indica el 5 de mayo de 2026). Este texto reproduce un artículo de Make publicado en esa fecha. El «nosotros» y las recomendaciones, herramientas, funciones y capturas son del autor de Make en esa fecha; no son una afirmación de este sitio ni una garantía de que esas apps, funciones o precios sigan igual hoy. Para el estado actual de la plataforma, consulta las fuentes oficiales de Make.
Descubre cómo la memoria de flujo de trabajo de agentes permite a los agentes de IA conservar el contexto entre sesiones. Aprende patrones de arquitectura y estrategias de implementación para 2026.
 Un cliente envía un ticket de soporte de seguimiento sobre un problema técnico en curso. El agente de triaje lo recibe, lo trata como un caso completamente nuevo y pide su ID de cuenta y los registros del sistema, información que ya había enviado ayer.
El operador detecta el duplicado, interviene e inmediatamente ve lo que pasó. El agente no tenía memoria del intercambio anterior.
Ese es el problema central al trabajar con la memoria de flujo de trabajo de agentes.
Desde la perspectiva del cliente, la automatización es tan frustrante como la vieja bandeja de entrada manual. Desde la perspectiva del operador, el agente hizo exactamente lo que fue construido para hacer: empezar de cero cada vez.
¿Qué es la memoria de flujo de trabajo de agentes?
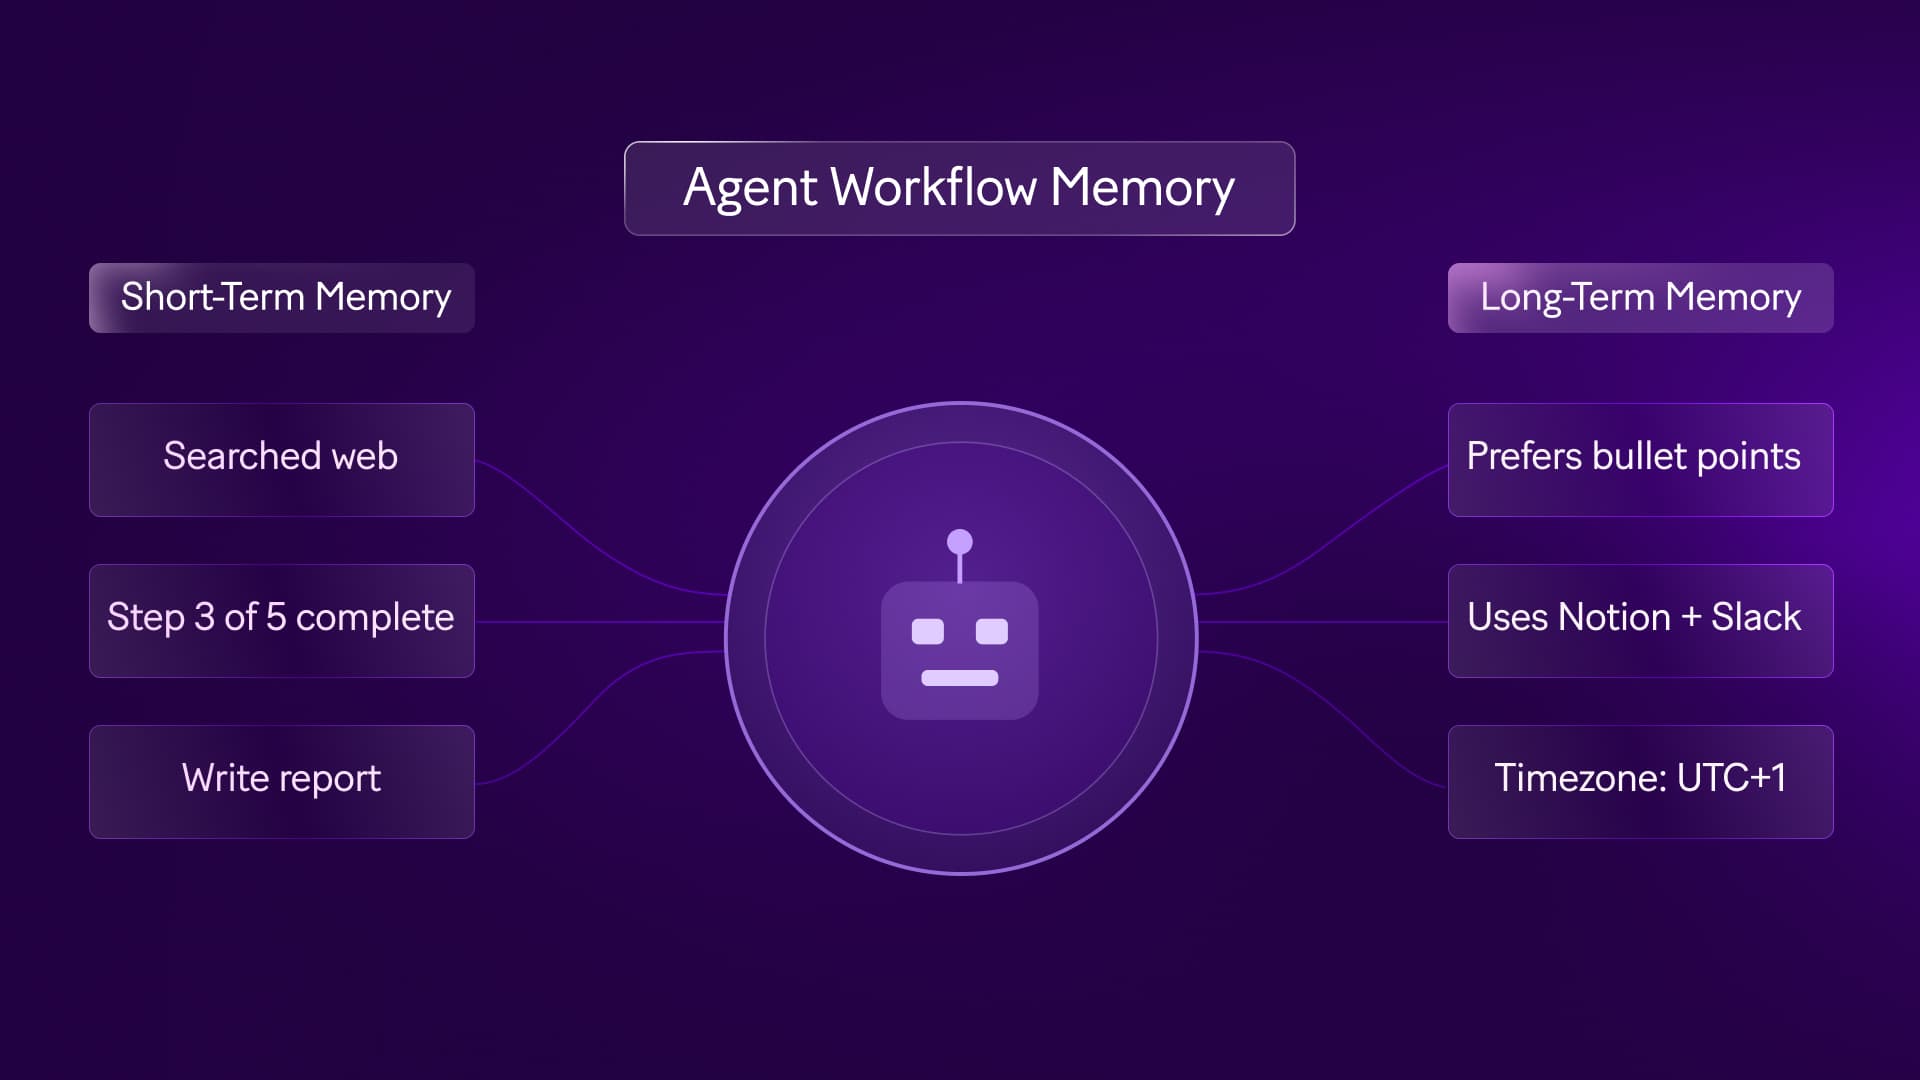
La memoria de flujo de trabajo de agentes es la forma en que un agente de IA accede al contexto y lo conserva entre triggers, sesiones y pasos, de modo que cada acción pueda estar informada por lo que vino antes. Sin marcos de memoria sistematizados, estos agentes se ejecutan sin estado y acabas desperdiciando muchos tokens, y es probable que alcances tus límites de uso más rápido en muchas de las herramientas de IA disponibles actualmente. Procesan una entrada, devuelven una salida e inmediatamente olvidan que el intercambio ocurrió. Al construir , encontrarás tres tipos de arquitecturas de memoria. Cada una gestiona el contexto de forma diferente:
- Memoria en contexto: es todo lo que el agente puede «ver» durante una sola sesión: el historial de la conversación, la entrada actual y cualquier instrucción que hayas incluido en el prompt. Es temporal. Cuando la operación termina, desaparece.
- Memoria externa: son datos estructurados que escribes en una base de datos, un CRM o un data store al final de una ejecución, y que recuperas al inicio de la siguiente. Es memoria persistente que se mantiene activa entre días, sesiones y triggers.
- Memoria de procedimiento: es la lógica y los patrones de razonamiento codificados directamente en las instrucciones del agente o ajustados en el propio modelo. Da forma a cómo piensa el agente, pero es lenta de actualizar y no sirve para almacenar el estado vivo del cliente.
También puedes encontrar referencias a la memoria episódica, que se refiere a registros de eventos pasados. Aunque es útil para auditorías, los escenarios operativos dependen en gran medida de la memoria externa, escribiendo y leyendo el estado de forma fiable para que el agente nunca empiece desde cero. En Make, los agentes se ejecutan dentro de escenarios. El escenario es el flujo de trabajo que gestiona triggers, búsquedas, enrutamiento y escrituras. El agente es el módulo de IA que toma decisiones basándose en el contexto que el escenario le proporciona. Cuando hablamos de memoria de flujo de trabajo de agentes, hablamos de cómo el escenario recupera y almacena el contexto para que el agente pueda actuar sobre él.
Por qué falla la memoria en producción
Un fallo de memoria significa que el agente toma una decisión sin acceso a contexto que debería haber tenido, lo que lleva a preguntas redundantes, enrutamiento incorrecto o acciones que ignoran el historial previo. Los fallos de memoria rara vez empiezan en el modelo. Proceden de identificadores que faltan, lógica de búsqueda débil o estado escrito en un formato que los módulos posteriores no pueden procesar. Los equipos suelen asumir que la memoria de IA para agentes significa que el modelo recordará los intercambios anteriores por sí solo, pero la verdadera necesidad es un mecanismo fiable para recuperar el contexto correcto en el momento correcto. En la práctica, la memoria se rompe de una de estas tres formas:
- El escenario no encuentra el registro anterior
- El registro anterior está desactualizado, o el estado recuperado es demasiado verboso para sostener una decisión limpia.
- Cada modo de fallo tiene un aspecto diferente en producción.
Pero todos producen el mismo resultado: el agente se comporta de forma inconsistente.
¿Cuál es la diferencia entre arquitectura de memoria y capacidad del modelo?
La arquitectura de memoria es el sistema que construyes para almacenar y recuperar contexto entre operaciones. La capacidad del modelo es la eficacia con la que la IA razona sobre el contexto que le proporcionas. Son cuestiones separadas. Los equipos a menudo tratan la memoria como un problema de selección de modelo. No lo es. Un modelo mejor puede razonar con más eficacia sobre el contexto que le das, pero no puede recuperar contexto que no persististe en primer lugar. Por eso los sistemas de memoria de flujo de trabajo deben evaluarse como arquitectura de datos, no como ingeniería de prompts. Si la estructura de tus registros no es fiable, tu agente producirá errores conscientes del contexto en el mejor de los casos, y errores ciegos al contexto en el peor.
¿Cómo usas la memoria de flujo de trabajo de agentes en tu negocio?
Configurar la memoria de flujo de trabajo de agentes significa decidir dónde debe recordarse el contexto entre sesiones, y luego construir la lógica para escribirlo al final de una ejecución y recuperarlo al inicio de la siguiente. Dónde necesitas que se recuerde el contexto depende enteramente del proceso. Una tarea de resumen de un solo paso no necesita memoria externa. Un flujo de incorporación de clientes de varios días, sí. Tomemos un agente de incorporación que gestiona la admisión inicial, envía una confirmación, supervisa los documentos que faltan y hace seguimiento durante cinco días laborables. La memoria en contexto funciona bien para la primera sesión, en la que el agente recibe el formulario de admisión, lo evalúa y genera un email de bienvenida. Pero cuando el cliente responde el tercer día con un documento requerido, el escenario se dispara de nuevo. Sin memoria externa, el agente no sabe qué documento faltaba ni quién es el cliente.
¿Qué deberías almacenar en la memoria externa?
La memoria externa es cualquier almacén de datos persistente fuera del propio agente. Puede ser una base de datos, un CRM o un módulo de data store donde escribes el estado estructurado al final de una ejecución del escenario y lo recuperas al inicio de la siguiente. A diferencia de la memoria en contexto (que solo existe dentro de una sola sesión), la memoria externa sobrevive entre triggers, días e incluso semanas. Los mejores payloads de memoria son compactos, tipados y vinculados a una clave de negocio. Almacena el ID del cliente, el ID del caso activo, el estado actual, el último evento significativo y el contexto mínimo necesario para la siguiente decisión. Si un valor de campo puede hacer el trabajo, no almacenes prosa. Aquí es donde la optimización de la memoria en tiempo real pasa de teórica a práctica. Mejoras la calidad de la recuperación reduciendo la ambigüedad, nombrando los campos de forma consistente, versionando los cambios de esquema y decidiendo qué valores puede usar el módulo de IA sin revalidarlos.
¿Qué aspecto tiene un diseño práctico de registro de memoria?
Un registro de memoria es el objeto de datos estructurado que almacenas después de cada ejecución de la automatización. Es el paquete de campos que el agente recuperará la próxima vez que necesite contexto sobre este cliente, caso o proceso. Para soporte, un objeto de memoria útil podría incluir el estado del ticket, la clasificación de sentimiento anterior, el último intento de resolución, los adjuntos requeridos y el responsable de escalado. Para incorporación: estado del contrato, documentos de cumplimiento que faltan, región y marca de tiempo del último contacto. Estos campos respaldan decisiones posteriores sin obligar al modelo a procesar un historial de interacción completo cada vez. Ese registro también debe incluir la propiedad de las actualizaciones. Si dos escenarios pueden escribir sobre el mismo estado del cliente, define qué escenario es dueño de qué campos. Sin esa regla, la memoria se convierte en una superficie disputada y las colisiones de estado se vuelven mucho más probables.
¿Cuáles son los beneficios de la memoria de flujo de trabajo de agentes?
El beneficio central de la memoria de flujo de trabajo de agentes es la consistencia: los agentes se comportan de forma fiable a lo largo del tiempo, entre sesiones y entre las personas que interactúan con ellos. Cuando la memoria funciona, los clientes no se repiten. Los traspasos de agente a humano llevan el contexto adecuado, así que los operadores no empiezan desde cero. Y cuando las decisiones salen mal, puedes auditar exactamente lo que el agente sabía en cualquier momento. No son solo ganancias de eficiencia: son la diferencia entre un agente que genera confianza y uno que la erosiona tras la tercera interacción inconsistente.
- Continuidad contextual : los clientes interactúan con un agente que ya conoce su historial.
- Toma de decisiones auditable : los operadores pueden inspeccionar las variables exactas que influyeron en cada decisión.
- Traspasos eficientes : las escaladas a humanos incluyen resúmenes estructurados de cada paso previo del agente.
- Menos trabajo redundante : los escenarios no repiten lo que ya completaron en una ejecución anterior.
Añadir memoria no hace que un agente sea más inteligente. Lo hace más consistente. Un agente con memoria bien diseñada y un modelo de razonamiento débil seguirá produciendo salidas pobres, pero serán salidas pobres con información de contexto.
¿Dónde aporta valor primero la memoria de flujo de trabajo de agentes?
El valor de negocio aparece primero en la reducción de fricción: menos solicitudes duplicadas, menos escaladas manuales y menos tiempo reconstruyendo el historial. Por eso los sistemas de soporte con agentes eficientes dependen menos de una generación de lenguaje pulida y más de una recuperación de estado fiable. La segunda ganancia está en la supervisión. Cuando una decisión sale mal, tu equipo puede rastrearla hasta el paquete exacto que el escenario recuperó. Ese nivel de observabilidad importa cuando necesitas explicar por qué un agente escaló, aprobó o aplazó un caso. La segunda ganancia aparece en la supervisión. Los equipos pueden revisar una decisión fallida y rastrearla hasta el paquete exacto que el escenario recuperó. Ese nivel de observabilidad es clave cuando necesitas explicar por qué un agente escaló, aprobó o aplazó un caso.
¿Cómo se usa la memoria de flujo de trabajo de agentes en la práctica?
Los equipos que hoy usan memoria persistente de agentes necesitan apoyarse en patrones de diseño específicos para gestionar el estado entre muchas herramientas a menudo desconectadas. Por ejemplo, los agentes de soporte de cara al cliente suelen usar búsquedas en el CRM como su mecanismo de memoria principal. Cuando llega un email, el escenario consulta Salesforce, extrae el historial de casos reciente y pasa esos datos estructurados al modelo. De manera similar, los agentes internos de TI suelen mantener el estado de los tickets entre días laborables. Si un empleado solicita acceso a un software, el agente registra la solicitud, avisa a un manager para su aprobación y queda inactivo. Cuando el manager hace clic en aprobar, un webhook dispara una nueva operación que recupera los detalles de la solicitud inicial y aprovisiona la cuenta. Aunque estos patrones son estables, otros aún están madurando:
- Generación aumentada por recuperación (RAG) : usar RAG como mecanismo de memoria funciona para conocimiento estático, pero requiere una indexación estricta y gestión de frescura cuando se aplica a estados de cliente que cambian rápido.
- Memoria compartida entre múltiples agentes : pasar contexto entre agentes completamente independientes dentro del mismo ecosistema es un reto arquitectónico activo.
- Colisiones de estado : si dos eventos disparan el mismo flujo de trabajo simultáneamente, escribir de vuelta en el data store puede causar condiciones de carrera en las que una actualización sobrescribe a la otra.
Para ver cómo estos conceptos encajan en operaciones más amplias, revisa el Blog de Make para análisis técnicos en profundidad, o examina los flujos de trabajo web escalables para entender cómo la recuperación de datos da forma a la lógica.
¿Cuáles son los patrones arquitectónicos comunes para la memoria de flujo de trabajo de agentes?
Un patrón arquitectónico es un diseño reutilizable para cómo los escenarios gestionan la memoria entre pasos. Estos patrones definen cuándo el escenario lee el estado, se lo pasa a un agente y escribe la decisión del agente de vuelta en el almacenamiento. Un patrón común es búsqueda-clasificación-escritura. El escenario recibe un evento, recupera el estado actual, lo pasa a un módulo de IA (el agente) para clasificar la intención o el riesgo, y escribe el estado actualizado de vuelta en el almacenamiento. Este patrón funciona bien para soporte, cualificación de leads y admisión de compras, y en cualquier lugar donde la decisión del agente dependa del estado anterior. Otro patrón es espera-reanudación-finalización. La primera operación crea el estado y hace una pausa hasta que llega una señal posterior: una aprobación, un pago o la subida de un documento. Cuando esa señal dispara el escenario de nuevo, este recupera el registro anterior y se lo pasa al agente para completar la siguiente acción con plena continuidad.
¿Qué riesgos subestiman los equipos con la memoria de flujo de trabajo de agentes?
El mayor riesgo no es la ausencia total de memoria, sino la memoria parcial que parece fiable hasta que surge un caso límite. Un agente que tiene acceso al estado del ticket pero no al nivel de producto puede enrutar a clientes enterprise a la cola de soporte equivocada. Un agente que ve una fecha de contacto pero no el estado de baja puede crear un problema de cumplimiento. Los equipos también subestiman la política de retención. La memoria persistente crea valor operativo, pero también crea responsabilidades de gobernanza. Necesitas reglas explícitas para la caducidad, la eliminación y la rehidratación, especialmente si el agente depende de datos de clientes regulados.
Cómo usar la memoria de flujo de trabajo de agentes en Make
Make es la plataforma de automatización visual donde construyes los escenarios que gestionan la memoria de flujo de trabajo de agentes. Es donde conectas data stores, enrutas el contexto entre módulos y diseñas la lógica que determina qué se guarda y cuándo. El Scenario Builder te muestra exactamente dónde se captura, se pasa y se escribe el contexto — o dónde se pierde. Puedes ver tu arquitectura de memoria directamente, en lugar de inferirla a partir de mapeos de campos ocultos. Cuando en Make, puedes usar los módulos de data store integrados para gestionar la memoria externa sin una integración de base de datos separada. Un escenario empieza con una lectura del data store, pasa el paquete recuperado a un módulo de IA y termina con una escritura en el data store que actualiza el registro. Como el Scenario Builder muestra la salida de cada módulo, puedes inspeccionar el contexto exacto que recibió tu agente. Si el contexto recuperado está incompleto, lo verás en el historial de operaciones antes de que la IA lo procese. Make también admite orquestación de varios modelos de IA dentro de un mismo escenario. Un módulo puede usar un modelo rápido y rentable para clasificar la intención, mientras un módulo posterior usa un modelo más capaz para generar una respuesta. Ambos modelos tienen acceso exactamente al mismo contexto recuperado, pasado entre módulos sobre el lienzo visual.
- Gestión visual del estado : inserta lecturas y escrituras del data store en escenarios existentes sin reconstruir la lógica.
- Gestión granular de errores : diseña rutas de fallo para asegurar que un estado corrupto no se escriba de vuelta en el almacén de memoria si una API falla.
- Acceso multimodelo : comparte el contexto recuperado entre distintos proveedores de IA dentro del mismo lienzo.
- Payloads observables : audita los paquetes exactos que se pasan al prompt.
Si gestionas entornos complejos, usa Make Grid para mapear cómo distintos escenarios y agentes interactúan con tus data stores compartidos. Tanto si usas la memoria para automatizar el procesamiento de feedback como para orquestar que conservan las preferencias del usuario, la visibilidad del flujo de datos es obligatoria. Incluso puedes extender esta lógica cuando operaciones de backend que dependen de acciones históricas del usuario.
¿Qué aspecto tiene una construcción de referencia en Make?
Una construcción de referencia es una estructura de escenario probada que puedes adaptar a tu propio caso de uso. Es una plantilla de partida que muestra dónde va cada tipo de módulo y cómo se pasan los datos entre pasos. Un patrón robusto en Make empieza con un módulo trigger, seguido de una búsqueda contra un data store o sistema de origen indexada por el cliente o el caso. El siguiente módulo normaliza el paquete recuperado para que los módulos de IA posteriores reciban una estructura estable. Después de que el módulo de IA toma su decisión, routers y filtros ramifican el escenario basándose en esa decisión — y el módulo de escritura final actualiza el estado con el nuevo resultado, la marca de tiempo y la siguiente acción esperada. Esa estructura hace que la depuración sea significativamente mejor que con software de automatización de flujos de trabajo opaco. Puedes inspeccionar la salida de cada módulo, confirmar si la búsqueda tuvo éxito y aislar si el fallo vino de la recuperación, el mapeo, la salida del modelo o la lógica de escritura. Para equipos que evalúan el procesamiento inteligente con agentes en producción, esa transparencia importa más que demos pulidas.
¿Cómo se diseña para el fallo y la recuperación en flujos de trabajo de memoria?
Una ruta de recuperación es la lógica que construyes para gestionar los casos en los que la búsqueda de memoria falla, ya sea porque el registro no existe, está corrupto o la propia búsqueda devuelve un error. Si la búsqueda no devuelve ningún registro, decide si el escenario debe inicializar el estado, aplazar el caso o escalarlo a un humano. Si una ejecución falla después de que el agente ya haya tomado una decisión y enviado una respuesta, enruta el paquete a una ruta de gestión de errores para poder reconciliar el estado antes de que llegue el siguiente trigger. Aquí es donde el control a nivel de módulo de Make resulta útil. Puedes colocar validación antes del módulo de IA, ramificar condicionalmente sobre campos que faltan y evitar que registros no válidos contaminen operaciones posteriores. En otras palabras, no solo estás construyendo memoria de flujo de trabajo de agentes en Make: la estás gobernando en el punto donde la memoria puede fallar.
Siguientes pasos
La brecha entre un agente de IA que funciona una vez y uno que funciona de forma fiable durante semanas de interacciones reales con clientes es casi siempre una decisión de arquitectura de memoria. La memoria de flujo de trabajo de agentes convierte tus operaciones de ejecuciones sin estado y amnésicas en sistemas diseñados y persistentes que acumulan valor con el tiempo. Empieza por el escenario que está fallando ahora mismo. Encuentra el traspaso exacto donde tu agente pierde contexto que debería haber conservado: ese es tu primer objetivo de diseño de memoria. Abre ese escenario en Make, añade una lectura del data store antes de tu módulo de IA y ejecútalo. Verás inmediatamente si la decisión del agente cambia cuando tiene acceso al estado anterior. ¿Listo para construir agentes que recuerdan? Regístrate en Make y usa los módulos de data store integrados para añadir memoria persistente a tu primer escenario. Sin base de datos separada: solo arrastra, conecta y despliega.
Preguntas frecuentes
1. ¿Cómo empiezas a implementar memoria de flujo de trabajo de agentes en Make sin complicar demasiado el primer escenario? Empieza con un único objeto de estado persistente vinculado a un identificador estable, como un ID de caso o un ID de cliente. En Make, coloca una lectura del data store cerca del inicio del escenario y una escritura del data store al final, luego inspecciona el paquete recuperado en el historial de operaciones antes de ampliar la lógica. 2. ¿Qué suele romperse primero cuando se añade memoria de agente a un escenario de soporte o de incorporación? El fallo más común es una clave de búsqueda incorrecta o una estructura de registro inconsistente, no el propio módulo de IA. Usa filtros y módulos de validación antes del paso de IA para que el escenario ramifique limpiamente cuando un registro falta, está desactualizado o está mal formado. 3. ¿La memoria de flujo de trabajo de agentes significa que el modelo de IA recuerda conversaciones pasadas por sí solo? No. La memoria de flujo de trabajo de agentes es un patrón arquitectónico para persistir y recuperar contexto entre operaciones; no es una capacidad inherente del modelo. El modelo razona sobre el paquete que le proporcionas, así que el estado persistente debe vivir en un data store, un CRM u otra fuente controlada. 4. ¿Cómo se compara Make cuando necesitas inspeccionar y depurar el comportamiento de la memoria en varios escenarios? Make te da un lienzo visual, inspección de salidas a nivel de módulo e historial de operaciones que muestran exactamente dónde se leyó, se transformó o se perdió el contexto. Cuando la arquitectura abarca varios escenarios, Make Grid te ayuda a rastrear las dependencias de estado compartido en lugar de inferirlas a partir de configuración oculta. 5. ¿Cómo escalas un diseño de memoria inicial cuando varios sistemas necesitan compartir contexto? Define primero un esquema de estado canónico y luego deja que cada escenario sea dueño de campos específicos en lugar de permitir que todos los escenarios escriban todo. A partir de ahí, puedes añadir routers, lógica condicional y Make AI Agents que consumen la misma memoria estructurada preservando la auditabilidad entre módulos. 6. ¿Qué deberían planificar los equipos técnicos para los próximos 12 a 18 meses con la memoria de IA para agentes? Planifica una gobernanza más estricta en torno a la frescura, la retención y el intercambio de estado entre agentes, en lugar de asumir que los modelos más grandes resolverán las carencias de memoria. Los equipos que traten la memoria como parte de la arquitectura del escenario ahora estarán en mejor posición para orquestar Make AI Agents a través de flujos de soporte, operaciones y servicios internos más adelante.