May 5, 2026 | 8 minutes
Artigo histórico da Make (a fonte indica 5 de maio de 2026). Este texto reproduz um artigo da Make publicado nessa data. O «nós» e as recomendações, ferramentas, preços e capturas de tela são do autor da Make naquela data; não são uma afirmação deste site nem garantia de que esses apps, recursos ou preços continuem iguais hoje. Para o estado atual das plataformas, consulte as fontes oficiais.
Descubra como a memória de fluxo de trabalho permite que agentes de IA retenham contexto entre sessões. Aprenda padrões de arquitetura e estratégias de implementação para 2026.
 Um cliente envia um ticket de acompanhamento sobre um problema técnico em andamento. O agente de triagem o recebe, trata como um caso totalmente novo e pede o ID da conta e os logs do sistema — informações que ele já tinha enviado ontem.
O operador percebe a duplicidade, intervém e imediatamente vê o que aconteceu. O agente não tinha memória da conversa anterior.
Esse é o problema central ao trabalhar com memória de fluxo de trabalho de agentes.
Da perspectiva do cliente, a automação é tão frustrante quanto a velha caixa de entrada manual. Da perspectiva do operador, o agente fez exatamente o que foi construído para fazer: começar do zero a cada vez.
O que é memória de fluxo de trabalho de agentes?
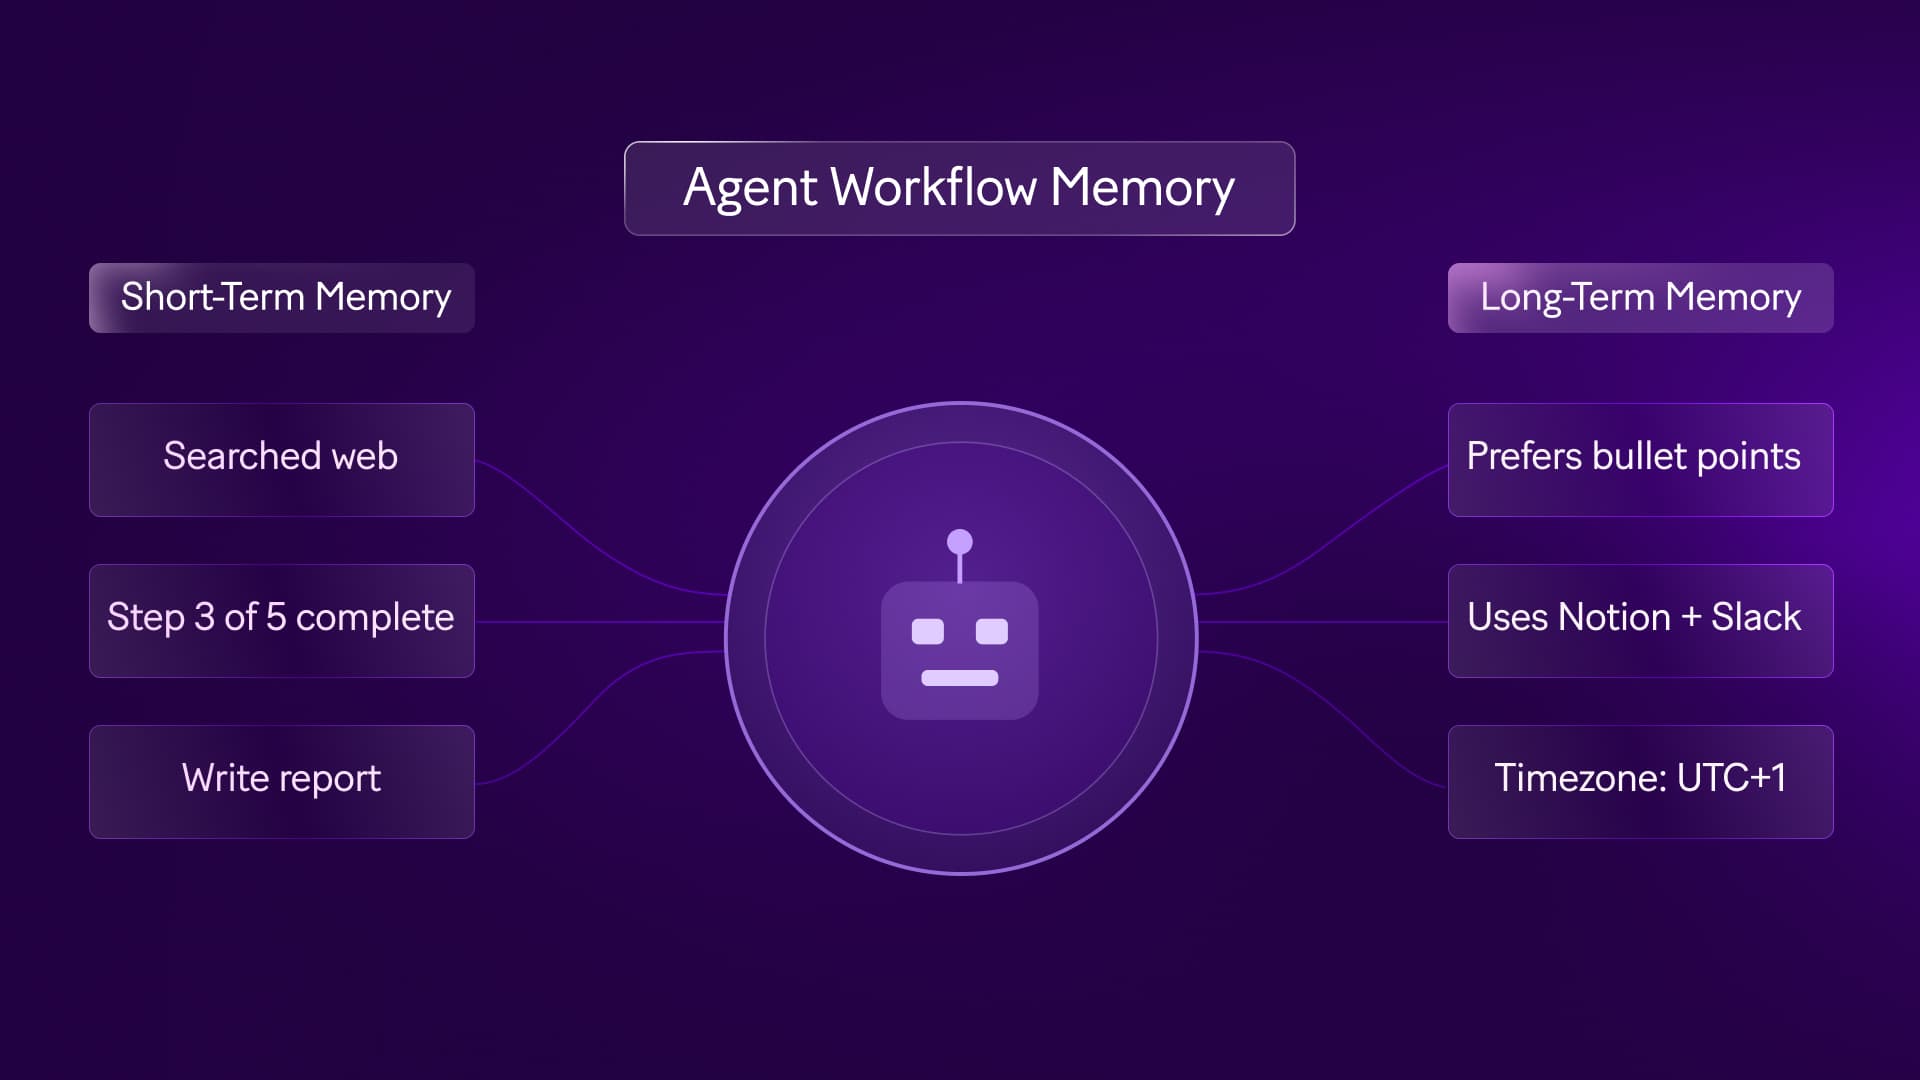
Memória de fluxo de trabalho de agentes é a forma como um agente de IA acessa e retém contexto entre gatilhos, sessões e etapas, de modo que cada ação possa ser informada pelo que veio antes. Sem frameworks de memória sistematizados, esses agentes rodam sem estado, e você acaba desperdiçando muitos tokens — e provavelmente vai atingir seus limites de uso mais rápido em muitas das ferramentas de IA atualmente disponíveis. Eles processam uma entrada, devolvem uma saída e imediatamente esquecem que a interação aconteceu. Ao construir , você encontrará três tipos de arquiteturas de memória. Cada uma lida com o contexto de forma diferente:
- Memória em contexto: é tudo o que o agente consegue "ver" durante uma única sessão — o histórico da conversa, a entrada atual e quaisquer instruções que você incluiu no prompt. É temporária. Quando a operação termina, ela desaparece.
- Memória externa: são dados estruturados que você grava em um banco de dados, CRM ou data store ao final de uma execução e recupera no início da seguinte. É memória persistente, que permanece ativa entre dias, sessões e gatilhos.
- Memória procedural: é a lógica e os padrões de raciocínio codificados diretamente nas instruções do agente ou ajustados no próprio modelo. Ela molda como o agente pensa, mas é lenta de atualizar e não serve para guardar o estado vivo do cliente.
Você também pode ver referências à memória episódica, que se refere a registros de eventos passados. Embora útil para auditoria, os cenários operacionais dependem fortemente da memória externa, gravando e lendo o estado de forma confiável para que o agente nunca comece do zero. Na Make, os agentes rodam dentro de cenários. O cenário é o fluxo de trabalho que cuida de gatilhos, consultas, roteamento e escritas. O agente é o módulo de IA que toma decisões com base no contexto que o cenário fornece. Quando falamos de memória de fluxo de trabalho de agentes, estamos falando de como o cenário recupera e armazena contexto para que o agente possa agir sobre ele.
Por que a memória falha em produção
Falha de memória significa que o agente toma uma decisão sem acesso ao contexto que deveria ter, levando a perguntas redundantes, roteamento incorreto ou ações que ignoram o histórico anterior. As falhas de memória raramente começam no modelo. Elas vêm de identificadores faltantes, lógica de consulta fraca ou estado gravado num formato que os módulos posteriores não conseguem interpretar. As equipes costumam presumir que memória de IA para agentes significa que o modelo vai lembrar as interações anteriores por conta própria, mas a necessidade real é um mecanismo confiável para recuperar o contexto certo na hora certa. Na prática, a memória quebra de três formas:
- O cenário não consegue encontrar o registro anterior
- O registro anterior está desatualizado, ou o estado recuperado é verboso demais para sustentar uma decisão limpa.
- Cada modo de falha parece diferente em produção.
Mas todos produzem o mesmo resultado: o agente se comporta de forma inconsistente.
Qual é a diferença entre arquitetura de memória e capacidade do modelo?
Arquitetura de memória é o sistema que você constrói para armazenar e recuperar contexto entre operações. Capacidade do modelo é a eficácia com que a IA raciocina sobre o contexto que você fornece. São preocupações separadas. As equipes costumam tratar memória como uma questão de seleção de modelo. Não é. Um modelo melhor consegue raciocinar com mais eficácia sobre o contexto que você dá, mas não consegue recuperar um contexto que você não persistiu em primeiro lugar. É por isso que sistemas de memória de fluxo de trabalho devem ser avaliados como arquitetura de dados, não como engenharia de prompt. Se a sua estrutura de registro não é confiável, seu agente vai produzir erros conscientes do contexto na melhor das hipóteses — e erros cegos ao contexto na pior.
Como usar memória de fluxo de trabalho de agentes no seu negócio?
Configurar a memória de fluxo de trabalho de agentes significa decidir onde o contexto precisa ser lembrado entre sessões e depois construir a lógica para gravá-lo ao final de uma execução e recuperá-lo no início da próxima. Onde você precisa que o contexto seja lembrado depende inteiramente do processo. Uma tarefa de sumarização de etapa única não precisa de memória externa. Um fluxo de onboarding de cliente de vários dias precisa. Pegue um agente de onboarding que cuida da entrada inicial, envia uma confirmação, monitora documentos faltantes e faz acompanhamento ao longo de cinco dias úteis. A memória em contexto funciona bem na primeira sessão, em que o agente recebe o formulário de entrada, o avalia e gera um e-mail de boas-vindas. Mas quando o cliente responde no terceiro dia com um documento obrigatório, o cenário é disparado de novo. Sem memória externa, o agente não sabe qual documento estava faltando — nem quem é o cliente.
O que você deve armazenar na memória externa?
Memória externa é qualquer armazenamento persistente de dados fora do próprio agente. Pode ser um banco de dados, CRM ou módulo de data store onde você grava o estado estruturado ao final de uma execução de cenário e o recupera no início da seguinte. Diferente da memória em contexto (que só existe dentro de uma única sessão), a memória externa sobrevive entre gatilhos, dias e até semanas. Os melhores payloads de memória são compactos, tipados e ligados a uma chave de negócio. Armazene o ID do cliente, o ID do caso ativo, o estado atual, o último evento relevante e o contexto mínimo necessário para a próxima decisão. Se um valor de campo resolve, não armazene prosa. É aqui que a otimização de memória em tempo real sai do teórico para o prático. Você melhora a qualidade da recuperação reduzindo ambiguidade, nomeando campos de forma consistente, versionando mudanças de esquema e decidindo quais valores o módulo de IA pode confiar sem revalidação.
Como é um design prático de registro de memória?
Um registro de memória é o objeto de dados estruturado que você armazena depois que cada automação é executada. É o conjunto de campos que o agente vai recuperar na próxima vez que precisar de contexto sobre aquele cliente, caso ou processo. Para suporte, um objeto de memória útil pode incluir status do ticket, classificação de sentimento anterior, última tentativa de resolução, anexos obrigatórios e responsável pelo escalonamento. Para onboarding: status do contrato, documentos de compliance faltantes, região e timestamp do último contato. Esses campos sustentam decisões posteriores sem forçar o modelo a interpretar um histórico completo de interações a cada vez. Esse registro também deve incluir a propriedade de atualização. Se dois cenários podem escrever no mesmo estado de cliente, defina qual cenário é dono de quais campos. Sem essa regra, a memória vira uma superfície disputada e as colisões de estado ficam muito mais prováveis.
Quais são os benefícios da memória de fluxo de trabalho de agentes?
O benefício central da memória de fluxo de trabalho de agentes é a consistência: os agentes se comportam de forma confiável ao longo do tempo, entre sessões e entre as pessoas que interagem com eles. Quando a memória funciona, os clientes não se repetem. As transferências de agente para humano carregam o contexto certo, então os operadores não começam do zero. E quando as decisões dão errado, você pode auditar exatamente o que o agente sabia em cada momento. Esses não são só ganhos de eficiência — são a diferença entre um agente que constrói confiança e um que a corrói depois da terceira interação inconsistente.
- Continuidade contextual : os clientes interagem com um agente que já conhece o histórico deles.
- Decisões auditáveis : os operadores podem inspecionar as variáveis exatas que influenciaram cada decisão.
- Transferências eficientes : os escalonamentos para humanos incluem resumos estruturados de cada etapa anterior do agente.
- Trabalho redundante reduzido : os cenários não repetem o que já completaram numa execução anterior.
Adicionar memória não torna um agente mais inteligente. Torna-o mais consistente. Um agente com memória bem desenhada e um modelo de raciocínio fraco ainda vai produzir saídas ruins, mas serão saídas ruins contextualmente informadas.
Onde a memória de fluxo de trabalho de agentes entrega valor primeiro?
O valor de negócio aparece primeiro na redução de atrito: menos pedidos duplicados, menos escalonamentos manuais e menos tempo reconstruindo histórico. É por isso que sistemas eficientes de suporte por agentes dependem menos de uma geração de linguagem polida e mais de uma recuperação de estado confiável. O segundo ganho está na supervisão. Quando uma decisão dá errado, sua equipe pode rastreá-la até o bundle exato que o cenário recuperou. Esse nível de observabilidade importa quando você precisa explicar por que um agente escalonou, aprovou ou adiou um caso. O segundo ganho aparece na supervisão. As equipes podem revisar uma decisão falha e rastreá-la até o bundle exato que o cenário recuperou. Esse nível de observabilidade é essencial quando você precisa explicar por que um agente escalonou, aprovou ou adiou um caso.
Como a memória de fluxo de trabalho de agentes é usada na prática?
As equipes que usam memória persistente de agentes hoje precisam de padrões de design específicos para lidar com estado entre muitas ferramentas, muitas vezes desconectadas. Por exemplo, agentes de suporte voltados ao cliente costumam usar consultas ao CRM como mecanismo principal de memória. Quando um e-mail chega, o cenário consulta o Salesforce, extrai o histórico recente de casos e passa esses dados estruturados ao modelo. Da mesma forma, agentes internos de TI costumam manter o estado do ticket ao longo de dias úteis. Se um funcionário solicita acesso a um software, o agente registra o pedido, aciona um gerente para aprovação e fica dormente. Quando o gerente clica em aprovar, um webhook dispara uma nova operação que recupera os detalhes do pedido inicial e provisiona a conta. Embora esses padrões sejam estáveis, outros ainda estão amadurecendo:
- Geração aumentada por recuperação (RAG) : usar RAG como mecanismo de memória funciona para conhecimento estático, mas exige indexação rigorosa e gestão de atualidade quando aplicado a estado de cliente que muda rápido.
- Compartilhamento de memória entre agentes : passar contexto entre agentes completamente independentes dentro do mesmo ecossistema é um desafio arquitetônico ativo.
- Colisões de estado : se dois eventos disparam o mesmo fluxo simultaneamente, a escrita de volta no data store pode causar condições de corrida em que uma atualização sobrescreve a outra.
Para ver como esses conceitos se encaixam em operações mais amplas, consulte o Blog da Make para análises técnicas profundas, ou examine fluxos de trabalho web escaláveis para entender como a recuperação de dados molda a lógica.
Quais são os padrões arquitetônicos comuns para memória de fluxo de trabalho de agentes?
Um padrão arquitetônico é um design reutilizável de como os cenários lidam com memória entre etapas. Esses padrões definem quando o cenário lê o estado, o passa para um agente e grava a decisão do agente de volta no armazenamento. Um padrão comum é lookup-classify-write. O cenário recebe um evento, recupera o estado atual, o passa para um módulo de IA (o agente) para classificar intenção ou risco, e grava o estado atualizado de volta no armazenamento. Esse padrão funciona bem para suporte, qualificação de leads e entrada de procurement — em qualquer lugar em que a decisão do agente dependa do estado anterior. Outro padrão é wait-resume-complete. A primeira operação cria o estado e pausa até que um sinal posterior chegue — uma aprovação, um pagamento ou o envio de um documento. Quando esse sinal dispara o cenário de novo, ele recupera o registro anterior e o passa ao agente para completar a próxima ação com total continuidade.
Quais riscos as equipes subestimam com memória de fluxo de trabalho de agentes?
O maior risco não é a falta total de memória — é a memória parcial que parece confiável até um caso de borda aparecer. Um agente que tem acesso ao status do ticket, mas não ao nível do produto, pode rotear clientes enterprise para a fila de suporte errada. Um agente que vê uma data de contato, mas não o status de opt-out, pode criar um problema de compliance. As equipes também subestimam a política de retenção. A memória persistente cria valor operacional, mas também cria responsabilidades de governança. Você precisa de regras explícitas para expiração, exclusão e reidratação, especialmente se o agente depender de dados de clientes regulamentados.
Como usar memória de fluxo de trabalho de agentes na Make
A Make é a plataforma de automação visual onde você constrói os cenários que cuidam da memória de fluxo de trabalho de agentes. É onde você conecta data stores, roteia contexto entre módulos e desenha a lógica que determina o que é salvo e quando. O Scenario Builder mostra exatamente onde o contexto é capturado, passado e gravado — ou perdido. Você pode ver sua arquitetura de memória diretamente, em vez de deduzi-la de mapeamentos de campo escondidos. Quando você na Make, pode usar os módulos de data store integrados para cuidar da memória externa sem uma integração de banco de dados separada. Um cenário começa com uma leitura do data store, passa o bundle recuperado a um módulo de IA e termina com uma escrita no data store que atualiza o registro. Como o Scenario Builder exibe a saída de cada módulo, você pode inspecionar o contexto exato que seu agente recebeu. Se o contexto recuperado estiver incompleto, você verá isso no histórico de operações antes que a IA o processe. A Make também suporta orquestração multi-modelo de IA dentro de um único cenário. Um módulo pode usar um modelo rápido e barato para classificar intenção, enquanto um módulo seguinte usa um modelo mais capaz para gerar a resposta. Os dois modelos têm acesso exatamente ao mesmo contexto recuperado, passado entre módulos na tela visual.
- Gestão visual de estado : insira leituras e escritas de data store em cenários existentes sem reconstruir a lógica.
- Tratamento de erros granular : desenhe rotas de falha para garantir que estado corrompido não seja gravado de volta no armazenamento de memória se uma API falhar.
- Acesso multi-modelo : compartilhe o contexto recuperado entre diferentes provedores de IA na mesma tela.
- Payloads observáveis : audite os bundles exatos passados para o prompt.
Se você gerencia ambientes complexos, use o Make Grid para mapear como diferentes cenários e agentes interagem com seus data stores compartilhados. Quer você use memória para automatizar o processamento de feedback ou para orquestrar que retêm preferências do usuário, a visibilidade do fluxo de dados é obrigatória. Você pode até estender essa lógica quando operações de backend que dependem de ações históricas do usuário.
Como é uma construção de referência na Make?
Uma construção de referência é uma estrutura de cenário comprovada que você pode adaptar ao seu caso de uso. É um template inicial que mostra onde cada tipo de módulo pertence e como eles passam dados entre etapas. Um padrão robusto na Make começa com um módulo de gatilho, seguido de uma consulta a um data store ou sistema de origem indexada pelo cliente ou caso. O módulo seguinte normaliza o bundle recuperado para que os módulos de IA a jusante recebam uma estrutura estável. Depois que o módulo de IA toma sua decisão, routers e filtros ramificam o cenário com base nessa decisão — e o módulo final de escrita atualiza o estado com o novo resultado, timestamp e próxima ação esperada. Essa estrutura torna a depuração significativamente melhor do que em softwares de fluxo de trabalho de automação opacos. Você pode inspecionar a saída de cada módulo, confirmar se a consulta teve sucesso e isolar se a falha veio da recuperação, do mapeamento, da saída do modelo ou da lógica de escrita. Para equipes avaliando o processamento por agentes inteligentes em produção, essa transparência importa mais do que demos polidas.
Como projetar para falha e recuperação em fluxos de memória?
Um caminho de recuperação é a lógica que você constrói para lidar com casos em que a consulta de memória falha — seja porque o registro não existe, está corrompido ou a própria consulta deu erro. Se a consulta não retornar registro, decida se o cenário deve inicializar o estado, adiar o caso ou escalonar para um humano. Se uma execução falha depois que o agente já tomou uma decisão e enviou uma resposta, roteie o bundle para um caminho de tratamento de erro para poder reconciliar o estado antes que o próximo gatilho chegue. É aqui que o controle em nível de módulo da Make se torna útil. Você pode colocar validação antes do módulo de IA, ramificar condicionalmente em campos faltantes e impedir que registros inválidos contaminem operações posteriores. Em outras palavras, você não está apenas construindo memória de fluxo de trabalho de agentes na Make — está governando-a no ponto onde a memória pode falhar.
Próximos passos
A distância entre um agente de IA que funciona uma vez e um que funciona de forma confiável ao longo de semanas de interações reais com clientes é quase sempre uma decisão de arquitetura de memória. A memória de fluxo de trabalho de agentes transforma suas operações de execuções sem estado e amnésicas em sistemas desenhados e persistentes que acumulam valor com o tempo. Comece pelo cenário que está falhando agora. Encontre a transferência exata onde seu agente perde contexto que deveria ter retido — esse é seu primeiro alvo de design de memória. Abra esse cenário na Make, adicione uma leitura de data store antes do seu módulo de IA e execute-o. Você verá imediatamente se a decisão do agente muda quando ele tem acesso ao estado anterior. Pronto para construir agentes que se lembram? Cadastre-se na Make e use os módulos de data store integrados para adicionar memória persistente ao seu primeiro cenário. Sem banco de dados separado — apenas arraste, conecte e implante.
FAQs
1. Como começar a implementar memória de fluxo de trabalho de agentes na Make sem complicar demais o primeiro cenário? Comece com um único objeto de estado persistente ligado a um identificador estável, como um ID de caso ou de cliente. Na Make, coloque uma leitura de data store perto do início do cenário e uma escrita no final, depois inspecione o bundle recuperado no histórico de operações antes de expandir a lógica. 2. O que geralmente quebra primeiro quando memória de agente é adicionada a um cenário de suporte ou onboarding? A falha mais comum é uma chave de consulta ruim ou uma estrutura de registro inconsistente — não o módulo de IA em si. Use módulos de filtro e validação antes da etapa de IA para que o cenário ramifique de forma limpa quando um registro estiver faltando, desatualizado ou malformado. 3. Memória de fluxo de trabalho de agentes significa que o modelo de IA lembra conversas passadas por conta própria? Não. Memória de fluxo de trabalho de agentes é um padrão arquitetônico para persistir e recuperar contexto entre operações — não é uma capacidade inerente do modelo. O modelo raciocina sobre o bundle que você fornece, então o estado persistente precisa viver em um data store, CRM ou outra fonte controlada. 4. Como a Make se compara quando você precisa inspecionar e depurar o comportamento da memória em vários cenários? A Make oferece uma tela visual, inspeção de saída em nível de módulo e histórico de operações que mostram exatamente onde o contexto foi lido, transformado ou perdido. Quando a arquitetura abrange vários cenários, o Make Grid ajuda a rastrear dependências de estado compartilhado em vez de deduzi-las de configurações ocultas. 5. Como escalar um design de memória inicial quando vários sistemas precisam compartilhar contexto? Defina primeiro um esquema de estado canônico e depois deixe cada cenário ser dono de campos específicos, em vez de permitir que todo cenário escreva tudo. A partir daí, você pode adicionar routers, lógica condicional e Make AI Agents que consomem a mesma memória estruturada, preservando a auditabilidade entre módulos. 6. Para o que as equipes técnicas devem se planejar nos próximos 12 a 18 meses com memória de IA para agentes? Planeje uma governança mais rigorosa em torno de atualidade, retenção e compartilhamento de estado entre agentes, em vez de presumir que modelos maiores vão resolver as lacunas de memória. Equipes que tratam memória como parte da arquitetura de cenários agora estarão em posição mais forte para orquestrar Make AI Agents em fluxos de suporte, operações e serviços internos depois.